
Az Európai Unió területén hamarosan digitális vízjelek kerülnek a ChatGPT és a Codex által kreált szövegekre – derül ki a fejlesztő OpenAI által tegnap kiadott tájékoztatásból. A vállalat nem rejti véka alá, hogy az intézkedés szorosan összefügg az EU-n belül a mesterséges intelligencia használatát szabályozó AI Act által előírt követelményekkel. A 2024-ben elfogadott, de elemeiben csak fokozatosan élesedő keretrendszer többek között előírja a nagy nyelvi modellek készítette tartalom gépi azonosításának lehetőségét, megkönnyítve ezzel például a hamisítások és csalások felderítését.
Az OpenAI jelenleg is alkalmaz olyan eszközöket, amelyekkel a modelljei kreálta képek és hanganyagok felismerhetők. Mindezt most azzal teszi teljesebbé, hogy digitális vízjeleket helyez el a szöveges kimenetelekben. A néhány héten belül minden EU-s ChatGpt- és Codex-csomagban alkalmazott textGrain elnevezésű technológia [PDF] a cég tájékoztatása szerint "láthatatlan statisztikai jelet ad hozzá a modell szóválasztásaihoz. Detektorunk ezt a jelet keresi, hogy megállapítsa, tartalmaz-e egy szövegrészlet OpenAI-vízjelet."
Ez nagyon leegyszerűsítve azt jelenti, hogy a modell szóválasztásába mesterségesen belenyúlnak, és egy adott kifejezés helyett egy másikat, jó esetben egy azzal egyenértékű szinonímát raknak. Ezt a statisztikai eltérést képes egy erre kihegyezett ellenőrző alkalmazás kimutatni a torzításmentes modell kimeneteleivel összehasonlítva.
Messze nem tökéletes
Az ellenőrzési technológia azonban szöveges kimenetek esetén még mindig gyerekcipőben jár, amit az OpenAI saját mérései is bizonyítanak. A teszteredmények szerint 200 szavas rövid szövegrészek esetében mindössze 80 százalékos pontossággal dolgozik a detektor, miközben ennek duplája esetén 95 százalék a sikerráta. Az eredményességet tovább rontja, ha olyan egzakt területekkel kapcsolatos az írás, mint amilyen a matematika és a kódolás. ezekben az esetekben ugyanis a helyettesítések magát a szöveghelyességet is lerombolhatják.
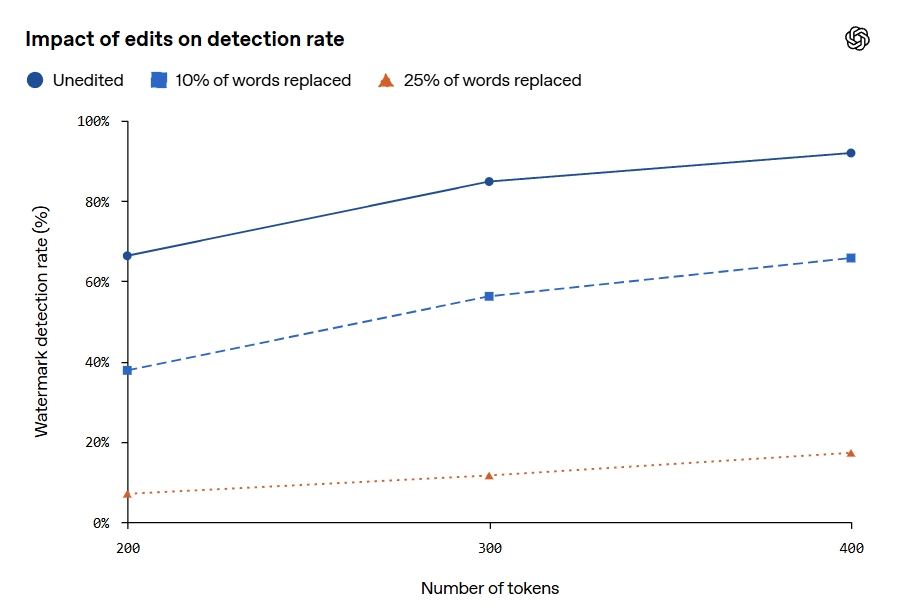
A helyes beazonosítást jószerével lehetetlenné teszi egy nem túl bonyolult trükk: a szöveg minimális átfogalmazása. Ahogy az OpenAI posztjából származó grafikonon is jól látható, egy 400 tokenből álló szövegrész esetében a szavak tizedének cseréjével 92-ről 66 százalékra csökken a vízjelfelismerési arány. Ha ugyanezt a cserét a szöveg negyedénél megtesszük, akkor pedig már mindössze az esetek 17 százalékában sikerül felismerni, hogy az alkotás mögött egy algoritmus van.
Pont a nem túl acélos sikerarányra hivatkozva a cég első körben kizárólag kutatóknak és szakértői szervezeteknek biztosítja majd a hozzáférést a vízjeldetektáló alkalmazáshoz, akik a remények szerint segíthetnek majd finomítani és pontosabbá tenni az azonosítást.
A vállalat egyébként az API-ügyfelek számára ugyancsak biztosítja a vízjelelhelyezés lehetőségét bizonyos modelleknél, de ez az opció amúgy alapesetben kikapcsolt állapotban marad. Mint ahogy egyelőre az EU-n kívül sem élesítik a felhasználói csomagoknál a detektálást támogató rendszert, mivel az OpenAI előbb szeretné levonni az itteni bevezetésből származó gyakorlati tapasztalatokat.
A tétlenség ára, avagy a legacy rejtett költségei
A legtöbb vállalat a modernizáció költségeit számolja. A valódi üzleti kockázat azonban gyakran nem a változtatás ára, hanem annak elhalasztása.
Forradalom az IT-ban – forradalom az IT-biztonságban
A generatív mesterséges intelligencia, AI-alapú automatizálás, az agentic AI alapjaiban rajzolta át a vállalatoknál az IT és az üzlet kapcsolatát – és ezzel együtt az IT-biztonsággal kapcsolatos elvárásokat és feladatokat.
a melléklet támogatója a CLICO

Projektek O-gyűrűje. Mit tanulhat egy projektvezető a Challenger tragédiájából?